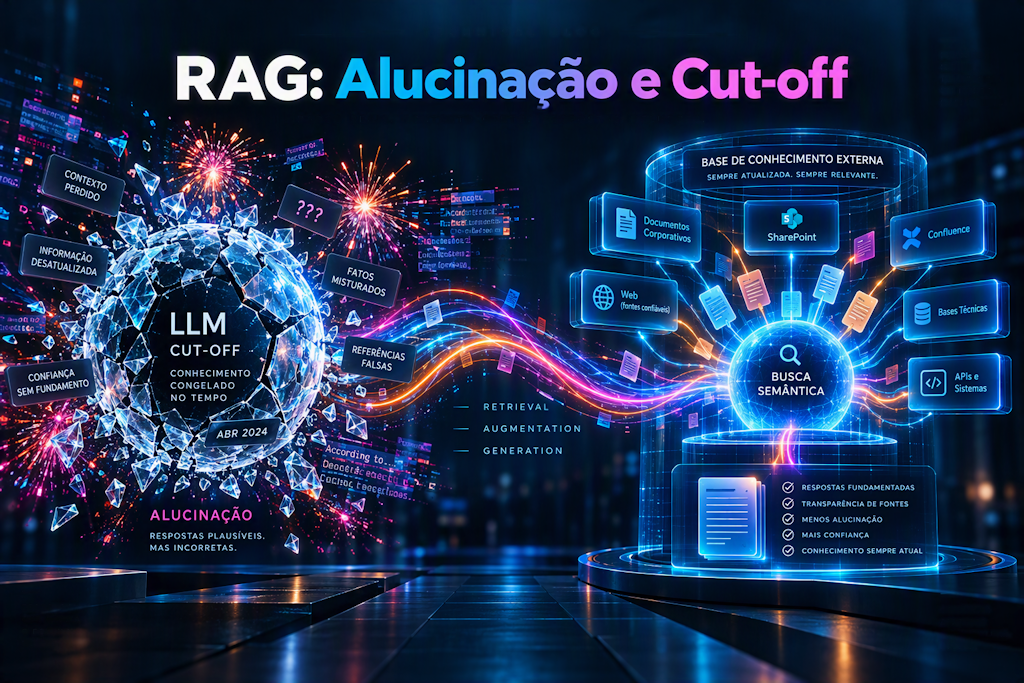
Nos dois primeiros posts desta série, foi construída a fundação técnica que os sistemas de IA corporativos precisam ter. No Post 1, escrevi que modelos semânticos e ontologias são o que dão significado aos dados de um negócio. Sem essa camada, os dados existem, mas não se comunicam entre si e o LLM não sabe o que eles representam no contexto da organização. No Post 2, expliquei como os embeddings transformam esse significado em coordenadas matemáticas, e como bancos de dados vetoriais armazenam e recuperam esse conhecimento com base em similaridade semântica. Trouxe o ponto também que os bilhões de parâmetros de um modelo são, em essência, o conhecimento comprimido que torna essa vetorização possível.
Só que, mesmo com toda essa base teórica bem construída, os LLMs têm limitações críticas que impactam seu uso corporativo direto. Primeiro que eles não sabem o que aconteceu depois do seu treinamento (cut-off), e segundo, que podem inventar respostas com total convicção quando não têm a informação certa (alucinação).
A solução de arquitetura para esses dois problemas tem um nome Retrieval-Augmented Generation (RAG). Isso ajuda o LLM a responder com conhecimento da sua empresa!
O que é RAG
RAG é uma arquitetura que combina dois componentes chaves para os LLMs conhecerem assuntos da sua empresa, sendo um sistema de recuperação de informação (retrieval) e um modelo de linguagem gerador (generation).
A lógica central é bem direta, em vez de confiar apenas no que o modelo aprendeu durante o treinamento, o RAG instrui o sistema a buscar primeiro nas fontes de conhecimento fornecidas e confiáveis, e só depois gerar a resposta, que é fundamentada no que foi encontrado.
Na prática, é como dar uma prova com consulta para o modelo. Ele continua responsável por criar e redigir a resposta, mas agora tem o material certo na mão. O LLM não é substituído, ele é complementado por um mecanismo que garante que ele está respondendo com base em informação real, não em estimativas probabilísticas. Você aumentou o conhecimento prévio do LLM com os dados da sua empresa.
O conceito central que o RAG habilita é o de grounding, que permite ancorar a resposta do modelo em fontes reais e verificáveis. Uma resposta com grounding pode ser rastreada até o documento de origem (igual fazemos com Data Lineage quando trabalhamos com Engenharia de Dados). O usuário sabe de onde a informação veio e pode verificar. Isso dá mais segurança, porque a resposta deixa de ser “a IA disse” e passa a ser “está na página 12 do manual tal, e aqui está o trecho”.
Alucinação e Cut-off
Antes de entrar nos detalhes técnicos de como o RAG funciona, é preciso entender com clareza os dois problemas que ele foi projetado para resolver. São fenômenos distintos, com causas distintas, mas que produzem o mesmo resultado: respostas incorretas entregues com total confiança.
Alucinação
Na disciplina da Inteligência Artificial, uma alucinação é quando um LLM gera conteúdo confiante, sintaticamente correto e semanticamente plausível, mas factualmente falso ou inventado. Antes de vir pra Microsoft eu mostrava em meus treinamentos uma interação com LLM onde eu conduzia uma conversa mostrando dois livros que escrevi e perguntava se eles tinham sido catalizadores para que eu participasse do Premio Jabuti na categoria de Tecnologia. A LLM dizia que sim e gerava uma resposta muito convincente do motivo. Mas o ponto é, eu nunca participei do Premio Jabuti, e o concurso nem tem uma categoria de Tecnologia. Tudo isso era alucinação da LLM.
E por que isso acontece? Bom, os LLMs são, em sua essência, modelos probabilísticos de linguagem (se você já viu alguma palestra recente minha, já me ouviu falando que a IA é uma grande calculadora estatística). Eles foram treinados para prever o próximo token mais provável em uma sequência, com base nos padrões estatísticos aprendidos de enormes volumes de texto. Isso significa que eles não consultam um banco de dados de fatos verificados. Eles produzem o texto que estatisticamente “faz sentido” dado o contexto da conversa, independentemente de esse txto corresponder à realidade.
Quando a pergunta toca em um assunto que o modelo não viu durante o treinamento, ou viu pouco, ele não tem um mecanismo nativo para dizer “não sei”. Ele gera o texto mais factível. E texto plausível sem lastro em fatos é, por definição, alucinação.
A nuance mais importante, e talvez que gere duvidas em quem está começando agora, é que alucinação não é um erro de raciocínio. É uma ausência de âncora/grounding. O modelo não tem como saber que não sabe, e por isso responde como se soubesse. E nos dá a impressão que ele tem um PhD naquele assunto!
Cut-off
O segundo problema é diferente na sua raiz, mas igualmente crítico para uso corporativo.
Todo LLM é treinado com dados coletados até uma data específica, isso é chamado de knowledge cutoff (data de corte). Não é como o Google que encontra a resposta quase que em tempo real. Após esse ponto, o modelo simplesmente não tem informações sobre o que aconteceu no mundo: novos eventos, mudanças de legislação, atualizações de produtos, novos concorrentes, variações de mercado.
Nestes mesmos treinamentos que conduzia, para explicar o Cut-Off, primeiramente eu pegava um modelo que a data de corte era Jan/2025 e perguntava quem era o atual campeão paulista de futebol da série A. Ele respondia que era o Palmeiras, porque era a informação que o LLM tinham até aquele momento. Porém, em 2025, o Corinthians foi campeão Paulista (em cima do Palmeira, inclusive).
E pra fazer graça eu mostrava uma foto minha com meu pai no Itaquerão vendo o jogo, e falava que a LLM estava errada. Mas era só pra gerar a atenção dos participantes do treinamento, porque em seguida eu pegava a informação atualizada do Campeão Paulista e “atualizava” a LLM. A partir daquele momento, a LLM tinha uma informação mais atual e conseguia responder que o Corinthians era o atual campeão paulista. Isso ajudava a ilustrar a diferença entre Alucinação e Cut-off. Contudo, em 2026 o Palmeiras ganhou de novo o Campeonato Paulista e essa demo parou de fazer sentido.
Por que isso acontece? O treinamento de um LLM é um processo fechado e computacionalmente caríssimo. Envolve milhares de servidores com GPUs caríssimas rodando por meses, processando trilhões e trilhões de operações matemáticas. Não é algo que se faz de forma contínua, muito menos no mini-mac em baixo da sua mesa. Porém, o modelo é fixado depois de treinado. Seus parâmetros não mudam em produção. Novos treinamentos de modelos geram novos modelos.
A diferença entre os dois
Só pra fixar, a alucinação é o modelo inventando algo que nunca existiu em nenhum momento, nem antes nem depois do treinamento. Cut-off é o modelo ignorando algo que existe, mas que aconteceu depois da data de corte do seu treinamento.
São causas diferentes. Mas o RAG combate as duas com a mesma estratégia! Fornecer contexto confiável no momento da consulta, antes da geração da resposta.
Contra a alucinação, ao recuperar os dados da sua fonte e fornecer chunks reais do conhecimento da organização como contexto, o modelo tem uma âncora factual. Ele passa a responder com base no que está no contexto fornecido, não no que imagina (ou inventa). Os sistemas de RAG mais modernos instruem explicitamente o LLM a responder apenas com base no contexto recebido, e a admitir quando a informação não está disponível.
Contra o cut-off, ao buscar informações em bases de conhecimento que são atualizadas continuamente, como documentos internos, bases de dados, feeds de informação, etc. O modelo acessa conhecimento posterior à sua data de corte… Publicou uma nova política ontem? Ela entra no índice em minutos e passa a alimentar as respostas imediatamente, sem precisar retreinar o modelo. Aqui sim é como se ele usasse o Google pra buscar a informação que precisa.
Como o RAG funciona?
Já conhecemos os problemas que o RAG ataca, agora podemos entender como ele os resolve na prática.
Na real, não existe um processo único e fechado definindo como o RAG deve funcionar. Mas em geral dá para construir um pipeline de RAG composto por algumas etapas que ocorrem a cada iteração:
- A pergunta chega: O usuário formula uma pergunta em linguagem natural. Pode ser simples (“Qual é a política de reembolso?”) ou complexa (“Compare os resultados do Q3 de 2025 com as projeções apresentadas no planejamento estratégico de janeiro”);
- A pergunta é vetorizada: O mesmo modelo de embedding utilizado na ingestão dos documentos transforma a pergunta em um vetor de alta dimensionalidade. Esse vetor captura o significado semântico da pergunta, não apenas as palavras, mas a intenção por trás delas;
- O banco de dados vetorial recupera os chunks mais relevantes: O vetor da pergunta é comparado com os vetores de todos os chunks indexados no banco vetorial. Os chunks com maior similaridade semântica são recuperados;
- O contexto é montado e o prompt é construído: Os chunks recuperados são inseridos no prompt enviado ao LLM, junto com a pergunta original e instruções explícitas no System Prompt: “Responda apenas com base no contexto fornecido. Se a informação não estiver disponível no contexto, diga que não foi possível encontrar a informação.” Isso transforma o RAG em uma ferramenta de grounding real;
- O LLM gera a resposta fundamentada: Com o contexto à sua disposição, o LLM gera uma resposta que integra o que foi recuperado com sua capacidade de raciocínio e linguagem. A resposta não vem da memória de treinamento, vem do contexto fornecido. E pode citar as fontes usadas, permitindo rastreabilidade completa.
Um ponto chave que determina a qualidade do sistema inteiro é a qualidade da resposta final. Ela pode ser limitada pela qualidade da recuperação. Um LLM excelente com um retriever ruim produz respostas ruins. A etapa de recuperação, e não a geração, é onde mora a maior parte da engenharia em sistemas RAG de produção. Guarde isso em mente, GIGO (Garbage In – Garbage Out)!
Limitações e cascas de banana
Seria irresponsável da minha parte apresentar o RAG apenas como solução bala de prata sem discutir o que ele não resolve sozinho. O RAG é poderoso, mas não é mágico. E a propósito, não existe bala de prata!
A qualidade dos dados de origem impacta a qualidade da resposta. Como escrevi no ultimo parágrafo da seção anterior, o RAG amplifica a qualidade dos documentos que recebe, mas se a base de conhecimento contém documentos desatualizados, contraditórios, mal estruturados ou incompletos, as respostas geradas serão igualmente falhas. “Garbage in, garbage out” se aplica com total precisão aqui. A governança dos dados de origem é tão importante quanto a arquitetura técnica.
O lado ruim do Chunking inadequado. Uma estratégia de chunking mal calibrada pode fazer com que os chunks certos nunca sejam recuperados, mesmo que o documento correto exista na base. O conteúdo está lá, mas fragmentado de forma que a busca por similaridade não o encontra. É como quando buscamos uma camiseta que gostamos mas não a encontramos na gaveta (e se chamar a esposa ela vai encontrar em 2 segundos e esfregar na nossa cara)!
Embeddings desatualizados ou inconsistentes. Se o banco vetorial foi indexado com um modelo de embedding e as consultas usam outro, a busca por similaridade perde precisão. A consistência entre o modelo de indexação e o modelo de consulta é fundamental. Por isso tenha atenção à arquitetura que usa para isso!
Latência de recuperação é um risco, já que cada etapa adiciona latência ao sistema: A vetorização da pergunta, a busca no banco vetorial, a montagem do contexto, uso de protocolos como MCP ou A2A, a geração são etapas sequenciais… Em sistemas de alta frequência de consultas, esse custo precisa ser gerenciado com caching, pré-computação e otimizações de infraestrutura. FIque atento ao tempo de resposta.
Limite de janela de contexto do LLM. Se muitos chunks são recuperados, o contexto montado pode exceder a janela de contexto do modelo. Mais não é sempre melhor, recuperar os chunks certos, não os chunks em maior quantidade, é o objetivo. É aqui que o reranking se torna indispensável. Modelos mais novos tentem a ter janelas de contextos maiores também. Assim como algoritmos de embeddings otimizados.
RAG nos produtos Microsoft
A Microsoft tem uma stack completa e integrada para entregar RAG em escala corporativa, conectando cada camada do pipeline de forma nativa.
O stack padrão de RAG no Azure tem Azure OpenAI + Azure AI Search. O Azure AI Search executa a recuperação híbrida, combinando busca por palavras-chave (lexical/BM25) e busca vetorial semântica, aplicando o algoritmo RRF (Reciprocal Rank Fusion) para combinar e reordenar os resultados das duas buscas antes de montar o contexto. O Azure OpenAI roda dentro do Foundry e recebe esse contexto enriquecido para gerar a resposta. Os dois serviços conversam de forma nativa, com latências otimizadas e governança unificada.
Azure AI Foundry é o orquestrador do pipeline RAG completo. O Azure AI Foundry oferece ferramentas visuais e programáticas para configurar cada etapa, desde a ingestão de documentos, estratégia de chunking, escolha do modelo de embedding, configuração do banco vetorial até a definição das regras de recuperação e dos prompts de geração. É o ambiente onde equipes de IA projetam, testam e colocam pipelines RAG em produção de forma gerenciada.
Microsoft Fabric + OneLake é onde os dados governados da organização estão. Pode conter relatórios, tabelas, documentos, históricos… A camada RAG pode ser aplicada diretamente sobre esses dados, sem mover informações entre sistemas, sem replicar controles de acesso e sem abrir mão da governança já estabelecida. O OneLake funciona como a camada de armazenamento unificado que alimenta o RAG com dados confiáveis e sempre atualizados.
Copilot Studio é para equipes que não querem ou não precisam de código, o Copilot Studio permite configurar RAG visualmente. Fontes de conhecimento utilizando SharePoint, sites públicos, arquivos, bases de dados, são conectadas como plugins de conhecimento, e o pipeline de recuperação e geração é gerenciado automaticamente pela plataforma. É o RAG acessível para toda a organização, não apenas para engenheiros.
Microsoft IQ é onde os três posts da série convergem. O Microsoft IQ é a camada que garante que o RAG corporativo tem um modelo semântico por trás. Os documentos recuperados têm significado definido e governado (Post 1), os embeddings que os representam são precisos e consistentes (Post 2), e o RAG orquestra tudo para gerar respostas fundamentadas no conhecimento real da organização (este post). É a integração das três fundações em uma plataforma que a Microsoft disponibiliza para o ambiente corporativo.
Pra encerrar…
Bom, o primeiro texto da série mostrou que modelos semânticos garantem que os dados têm significado definido, governado e compreensível tanto para humanos quanto para sistemas de IA. Já o segundo texto apresentou como embeddings transformam esse significado em coordenadas precisas no espaço vetorial, e como bancos de dados vetoriais tornam esse conhecimento recuperável com eficiência e precisão.
Este texto de hoje fecha o ciclo. Explica como o RAG usa essas coordenadas para encontrar o conhecimento certo, no momento certo, e fundamentar a resposta do LLM no que é real, não no que o modelo imagina ser verdade.
Empresas que combinarem as três fundamentações em seus projetos (modelo semântico robusto, pipeline de embeddings bem estruturado e arquitetura RAG bem projetada) terão agentes de IA que não apenas falam fluentemente a linguagem da empresa, mas que sabem o que estão falando. Agentes que podem ser auditados, corrigidos e confiados.
Quero tentar sentar e escrever um quarto e último post para esta série, que irá amarrar e materializar tudo isso no Microsoft IQ… Vamos aguardar 🙂
A imagem de capa foi feita no M365 Copilot com o promtp: Cria a imagem: Capa premium para blog técnico Microsoft. Fundo azul petróleo escuro, iluminação cinematográfica, visual sofisticado e futurista. À esquerda, uma esfera cristalizada e fragmentada representando o conhecimento congelado do LLM (o CUT-OFF) e fogos de artificios representando confusão com fragmentos de dados distorcidos ao redor simbolizando ALUCINAÇÃO. À direita, uma base de conhecimento externa viva, com documentos fluindo para um núcleo central brilhante via busca semântica. Estas bases de conhecimentos vivas devem estar em hologramas. Conexões em azul elétrico, laranja vibrante e rosa neon percorrendo o fluxo de retrieval e geração. Estilo Microsoft Design moderno, premium, executivo, extremamente limpo, alta densidade informacional, sem aparência de marketing genérico. Título grande: “RAG: Alucinação e Cut-off” com RAG escrito em Branco e o restante em degradê de azul para rosa
<br>


